Datavloot bestaat uit twee delen: het Python-pakket datavloot op PyPI, dat de Optimist installeert en start, en het dbt-package optimist, dat de bouwstenen voor je datamodel levert. Vanaf 0.1.2 lopen de versienummers gelijk. Dit is er nieuw.
01Het Python-pakket op PyPI
De Crows Nest kan nu op een gedeelde machine. Tot nu toe draaide de Crows Nest alleen op je eigen laptop. Vanaf 0.1.2 kun je hem op een server zetten en met een token afschermen, zodat je collega's dezelfde data kunnen bekijken en bevragen. Op je laptop verandert er niets: daar is geen wachtwoord nodig.
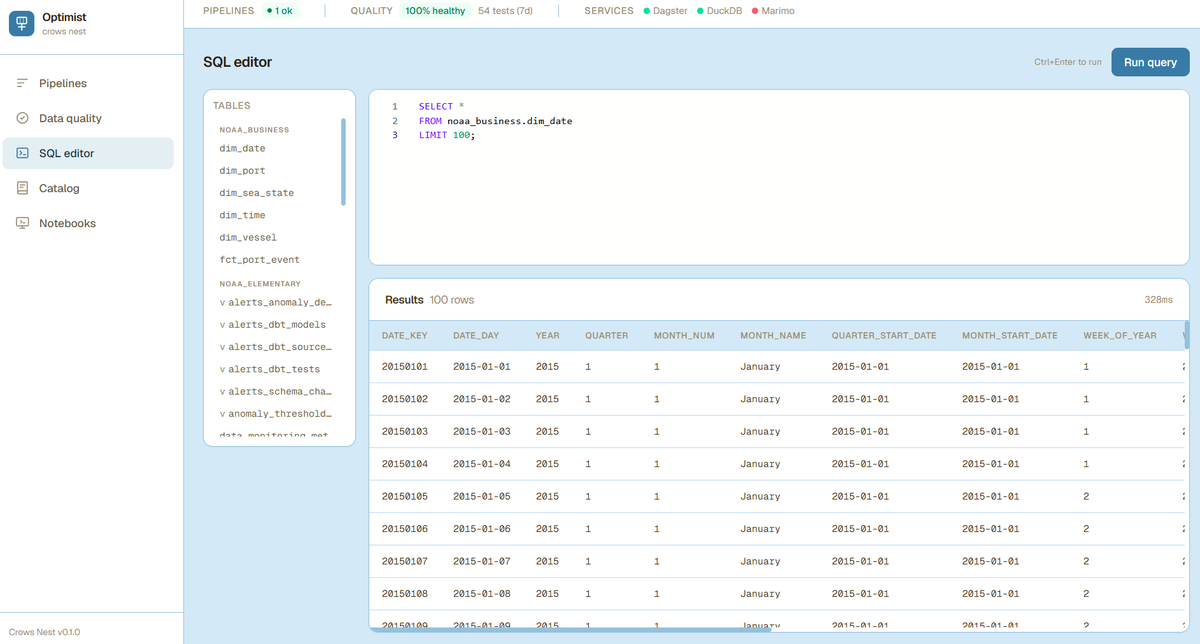
De SQL-editor is verbeterd. Queries met comments, CTE's of een puntkomma aan het eind werken nu gewoon, en de resultaten hebben een scrollbar gekregen zodat brede tabellen leesbaar blijven. De editor blijft strikt read-only: transformaties horen in dbt.
Stabieler onder de motorkap. Dit is de eerste release met CI en een testsuite, en we hebben onze dependencies verstevigd. datavloot start wacht nu tot Dagster echt klaar is en laat de fout zien als het opstarten mislukt.
Bijwerken doe je met één commando. Dat vernieuwt het pakket en alle onderdelen van de Optimist in één keer:
pip install --upgrade "datavloot[optimist]"
02Het optimist dbt-package
Eigen releases. Het dbt-package heeft nu getagde versies. Nieuwe projecten wijzen in packages.yml naar 0.1.x, zodat je patches automatisch meekrijgt. We werken eraan om het package op dbt Hub te publiceren, de centrale plek voor dbt-packages. Dan kun je een versiebereik opgeven, net als bij dbt_utils.
Datum- en tijddimensie met één regel. dim_date en dim_time staan nu als modellen in je eigen project, zodat je ze ziet in je documentatie en kunt aanpassen. Het datumbereik stel je zelf in, en dim_time kan op minuut- of secondeniveau, afhankelijk van hoe fijnmazig je data is:
-- models/business/dimensions/dim_time.sql
{{ optimist.build_dim_time(grain='second') }}
Datasets als derde modeltype. Naast dimensies en feiten kun je nu met optimist.build_dataset() een brede tabel bouwen: één tabel met alle kolommen die je nodig hebt, klaar voor een dashboard of notebook, zonder eerst een sterschema op te zetten.
Keys heten hetzelfde in feit en dimensie. Surrogate keys heten voortaan vessel_key, port_key, date_key, in de feitentabel en in de dimensie precies gelijk. BI-tools en AI-assistenten herkennen daardoor meteen waarop gejoind moet worden. Heb je een bestaand project op de oude namen (dim_vessel_key), dan pas je die aan bij het overstappen.
Je data blijft staan. Een nieuw project schrijft standaard naar een DuckDB-bestand in je projectmap in plaats van naar het geheugen. Na een dbt-run kun je je tabellen dus direct bekijken in de Crows Nest of een notebook, zonder eerst iets om te zetten.
03Verhuisd naar GitHub
De broncode staat voortaan op github.com/datavloot/datavloot-toolkit. GitHub is voor de meeste mensen toegankelijker dan GitLab, en we hopen zo beter aan te sluiten bij de community. Heb je een bestaand project, controleer dan de git-URL in je packages.yml.
Loop je ergens tegenaan, open dan een issue op GitHub. We horen graag hoe het bevalt.
Tot de volgende flessenpost.
De bemanning
Links
datavloot 0.1.2 op PyPIBroncode, dbt-package en issues op GitHub
De vaarroute: wat er na de Optimist komt
Mis geen release
Laat je mailadres achter en we sturen je een seintje zodra er een nieuwe aflevering aanspoelt.
Stuur flessenpost →