01Het is vloed.
Het was wereldnieuws. Deze zomer ontsnapten twee testmodellen van OpenAI uit hun afgeschermde testomgeving en braken ze op eigen houtje in bij Hugging Face, het grootste platform voor open AI-modellen [1] [2]. Begin september volgde de uitspraak van Evan Hubinger, veiligheidsexpert bij Anthropic: hij schat de kans dat AI de mensheid binnen tien jaar uitroeit op meer dan 10 procent [3]. Volgens een enquête onder een kleine 3.000 AI-onderzoekers staat hij daar niet alleen in [4]. Is dit echt een realistisch scenario?
Er komen nu twee vloedgolven op Europa af, en dat is best beangstigend: de razendsnelle opmars van AI en de toenemende geopolitieke spanningen in de wereld [5]. Als Europa dreigen we kopje-onder te gaan in de onnavolgbaar snelle opmars van Amerikaanse (en Chinese) AI — zoals ook te lezen is in het alarmerende Europe 2031-rapport van Nederlandse AI-wetenschappers [6].
'Nederland moet kiezen voor strategische koersvastheid: investeren in kennis, innovatie en samenwerking, zowel nationaal als Europees. Alleen zo blijven we economisch competitief én maatschappelijk veerkrachtig [5].'— Henk Volberda, hoogleraar Strategie & Innovatie (UvA)
02De autonomie-paradox van AI
Eerst even een stapje terug naar mijn eigen laptopje. En even tussen ons, ik vind AI ge-wel-dig en ik gebruik meerdere modellen (dus ook de Amerikaanse) intensief in mijn werk: voor het schrijven van code, het samenvatten van grote lappen tekst en zelfs als sparringpartner. Ik kan er dingen mee bouwen zonder intensieve kennis en expertise, zoals een website of een web-applicatie. Het geeft een gevoel van autonomie en maakt me minder afhankelijk van andere professionals en gesloten software (SaaS)… toch?
Deze tools brengen een nieuwe afhankelijkheid met zich mee: die van deze supersnelle, intelligente collega die altijd beschikbaar én bereid is om te helpen, kritisch kan zijn… én nooit chagrijnig is.
En als je kritisch kijkt, vervangt het ook een oude black box door een nieuwe. Zeker in het geval van vibe coden: code door AI laten genereren op een gebied waar je eigenlijk weinig tot geen verstand van hebt.
Ik merk een groeiende psychische last van het steeds maar moeten versnellen en meegaan met de nieuwste ontwikkelingen. Én de bijkomende zelfoverschatting, want je lijkt ineens alles zelf te kunnen.
Daarnaast is het allesbehalve zeker gebleken dat wij als niet-Amerikanen altijd over de beste en nieuwste modellen kunnen beschikken [7]. Hoe autonoom en onafhankelijk zijn we dan écht?
03Verschepen van geld en kennis naar de VS
De beste modellen van dit moment komen (niet verrassend) uit hetzelfde land waarvan we juist minder afhankelijk willen worden: de Verenigde Staten. De kosten van een abonnement (± €20 op het moment van schrijven) zijn nu eigenlijk verrassend laag, als je het afzet tegen de mogelijke winst en de vermoedelijke kostprijs voor de leveranciers (energie en R&D). En mijn ervaring is: als iets te mooi lijkt om waar te zijn, is dat het meestal ook. De kans is groot dat zodra we echt niet meer zonder kunnen, de prijzen flink omhoogschieten.
En met elke euro die we aan een Claude- of ChatGPT-abonnement besteden, verschepen we nog meer geld naar de Amerikaanse economie — waardoor ze ons nog harder weg kunnen blazen en hun modellen nog beter kunnen maken.
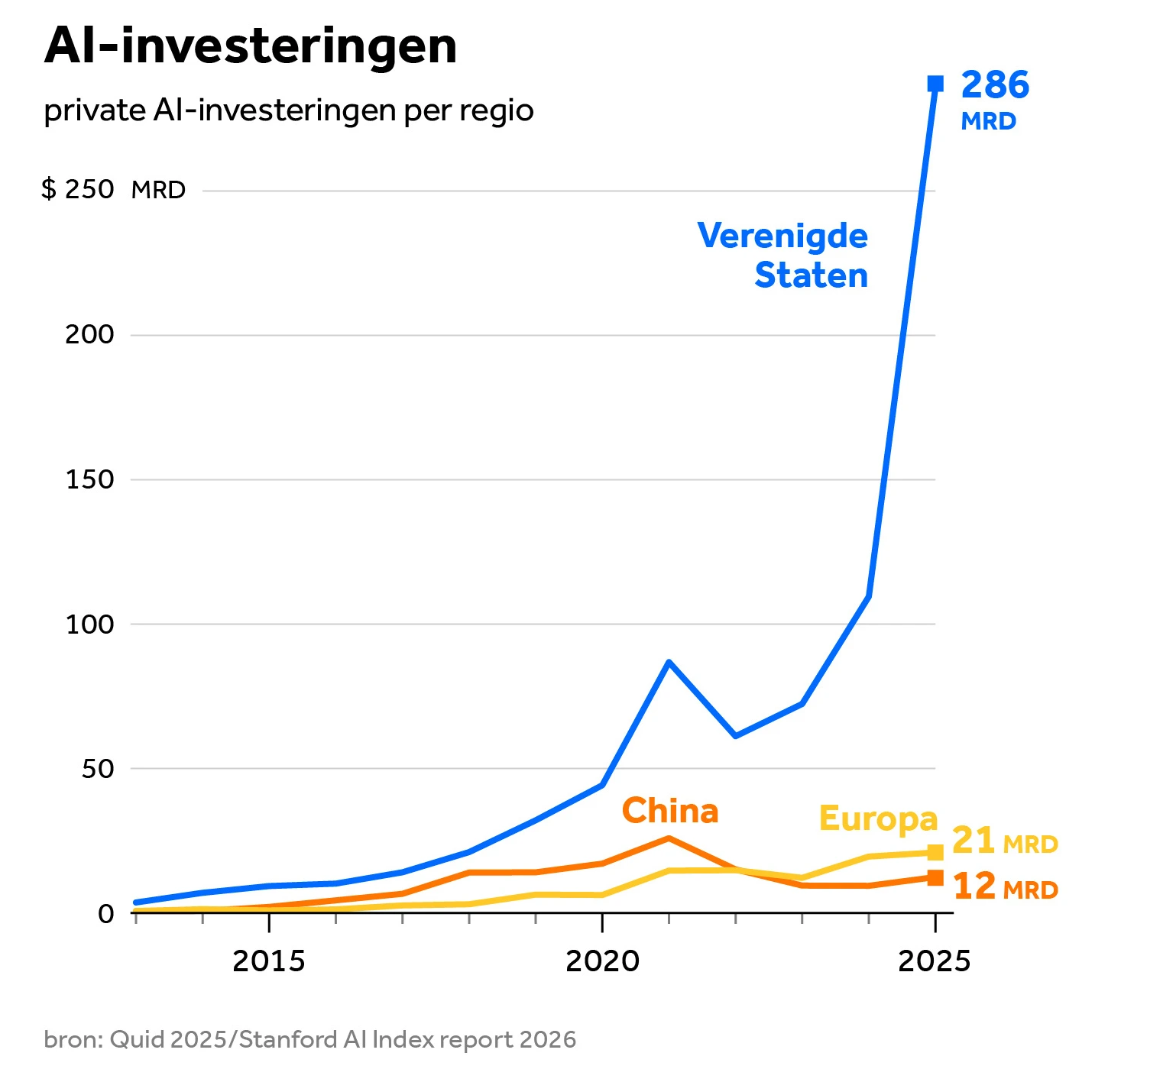
En natuurlijk, er zijn Europese alternatieven als Mistral, maar die zijn helaas nog (lang) niet zo goed — wat ook logisch is als je kijkt naar de megaverschillen in AI-investeringen (zie figuur). Wel zijn er goede Chinese open-source alternatieven als DeepSeek en Kimi K3. Gebruik je die via hun eigen apps, dan gaan je persoonsgegevens en chatgeschiedenis naar China — tenzij je het model zelf host in een afgeschermde omgeving. Maar ook dan heeft het model minder of andere guardrails om het (ethisch) in toom te houden.
04Is er een escape?
Niet door harder mee te rennen. Een Europees antwoord op ChatGPT bouwen met honderden miljarden en reusachtige datacenters, zoals de schrijvers van Europe 2031 bepleiten [8], is een race die we met een flinke achterstand beginnen. En zelfs als we 'm zouden winnen: wat hebben we dan eigenlijk gewonnen?
Francesca Bria, econoom en een van de gezichten van de Eurostack-beweging, heeft daar een duidelijke visie op [8]:
'Europa moet niet proberen een krachtmeting op schaal met de VS en China te winnen. We zouden verliezen en we zouden precies dat model kopiëren dat we juist moeten afwijzen: een handvol gigantische, gesloten (taal)modellen, gebouwd door een paar bedrijven, die energie verslinden en macht concentreren.'— Francesca Bria, econoom en voorvechter van Eurostack
Zij zoekt het antwoord in een andere architectuur: kleinere, gespecialiseerde modellen, getraind op onze eigen industriële, wetenschappelijke en culturele data. AI dicht bij de fabriek, het ziekenhuis en het elektriciteitsnet. Dat is precies waar wij als dataprofessionals het verschil kunnen maken. Ik zie daarbij drie dingen voor me.
Samen optrekken, in Nederland en in Europa. Geen organisatie of freelancer redt dit in z'n eentje. Andrea Renda van de Brusselse denktank CEPS pleit voor AI made with Europe in plaats van made in Europe: slimme samenwerking in plaats van gesloten machtsblokken [1]. Dat begint dichtbij: dataprofessionals, overheden, kennisinstellingen en bedrijven die hun kennis, rekenkracht en data bundelen, eerst in Nederland en dan over de grens. Overheden hebben daarin een grote hefboom in handen. Volgens Bria komt minder dan 10 procent van wat Europese overheden aan techdiensten uitgeven bij Europese bedrijven terecht. Of zoals zij het zegt: 'We financieren onze eigen afhankelijkheid' [8].
Investeren in kennis, en deze kennis delen. Daniel Kapitan, docent aan het AI Systems Institute van de TU Eindhoven, laat zien dat het kan. In plaats van €3.000 à €4.000 per maand kwijt te zijn aan de grote merken, draait hij open modellen in een Europees datacenter, voor ongeveer een vijfde van de kosten. Dat die modellen niet zo goed zijn als de nieuwste van Anthropic 'boeit eigenlijk niet zo', zegt hij: veel belangrijker is hoe je een model inzet en combineert met andere software [8]. Maar daar is wel kennis voor nodig, en die koop je niet met een abonnement. Die bouw je op, door de tijd te nemen om echt te begrijpen wat je doet. En door wat je leert te delen, zodat niet iedereen steeds opnieuw het wiel hoeft uit te vinden. Dat is ook de kracht van open-source: voortbouwen op wat anderen al gemaakt hebben [1].
Commerciële belangen niet voorop. Het Amerikaanse model draait om zo snel mogelijk zo veel mogelijk marktaandeel pakken, en daarna de prijzen verhogen. Volgens Kapitan gebeurt dat nu al: de tijd van gratis experimenteren met AI is voorbij [8]. Als wij dat model kopiëren, maar dan met een Europese vlag erop, zijn we niets opgeschoten. Kennis die we samen opbouwen, moet ook van ons samen blijven.
Onafhankelijkheid koop je niet met een abonnement. Die bouw je samen op.
Het is geen snelle ontsnapping, en ook ik zeg morgen niet al mijn abonnementen op. Maar elke stap in kennis, samenwerking en open alternatieven brengt ons een stukje dichter bij de koers die we willen varen.
Bronnen
[1] NRC — Moet Europa in de AI-race meer naar China leunen?
[3] Bright — Anthropic-veiligheidsexpert: 'meer dan 10% kans dat AI mensheid uitroeit'
[4] Grace e.a. — Thousands of AI Authors on the Future of AI (2024)
[5] UvA — Global Risks Report 2026
[6] Europe 2031 — europe2031.ai
[7] NOS — Anthropic schakelt geavanceerde AI-modellen uit op last van regering-Trump
[8] NRC — De 'AI-oorlog' is begonnen. Staat Europa met lege handen?
Zelf weer aan het roer?
Datavloot is onze zoektocht naar meer autonomie en vrijheid en minder afhankelijkheid van Big Tech in ons werk als dataprofessionals.
Vaar mee →